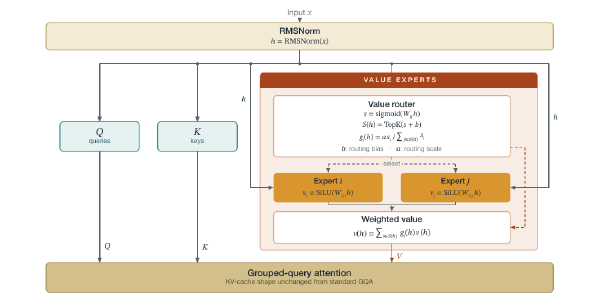
K2-Horizon: A Frontier Fleet of Open Source Language Models 21 November 2026·8 mins Machine Learning Paper Notes Machine-Learning Arxiv Llm Open-Source Mixture-of-Experts Pretraining Llm360
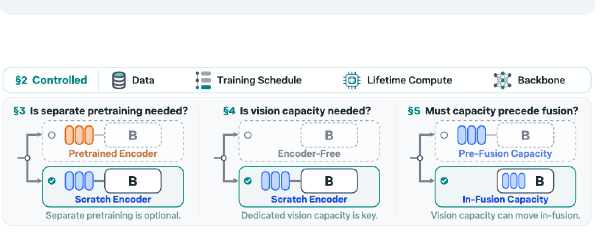
Unbundling Multimodal Vision Encoding 14 November 2026·10 mins Machine Learning Paper Notes Machine-Learning Arxiv Multimodal Vision-Language-Models Vision-Encoder Scaling-Laws Architecture
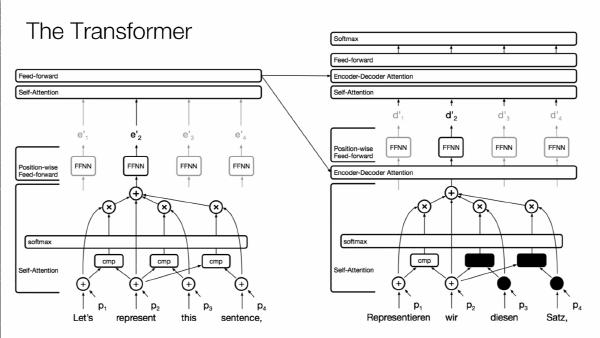
Self-Attention for Generative Models (Ashish Vaswani & Anna Huang, Stanford CS224N, 2019) 14 November 2026·8 mins Machine Learning Talk Notes Llm Transformers Self-Attention Deep-Learning Classic Stanford Music-Generation
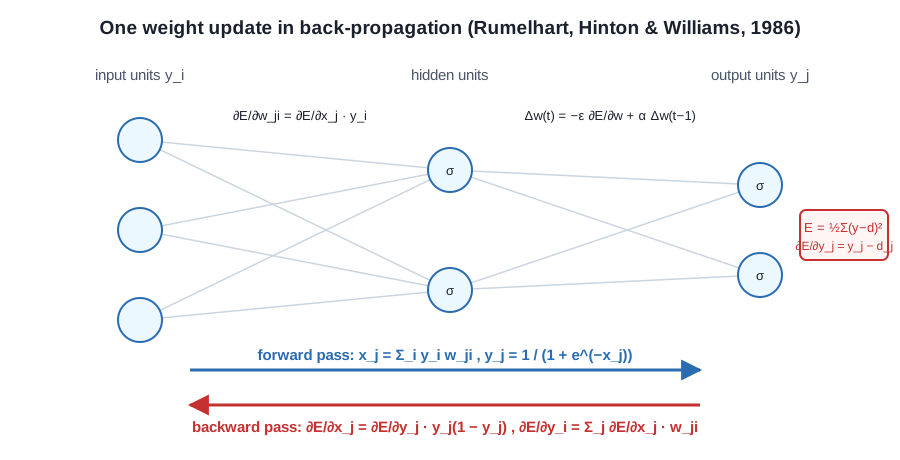
Learning Representations by Back-propagating Errors (Rumelhart, Hinton & Williams, 1986) 7 November 2026·7 mins Machine Learning Paper Notes Machine-Learning Classic Neural-Networks Backpropagation Deep-Learning Gradient-Descent Representation-Learning
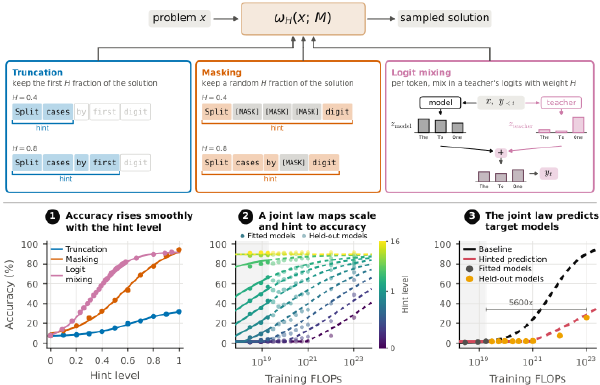
Hinted Scaling Laws 7 November 2026·7 mins Machine Learning Paper Notes Machine-Learning Arxiv Scaling-Laws Evaluation Benchmarks Llm
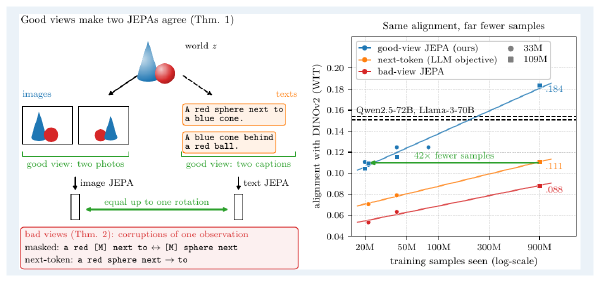
Proving and Improving the Platonic Representation Hypothesis with JEPAs 31 October 2026·13 mins Machine Learning Paper Notes Machine-Learning Arxiv Self-Supervised-Learning Jepa Representation-Learning Multimodal Lecun
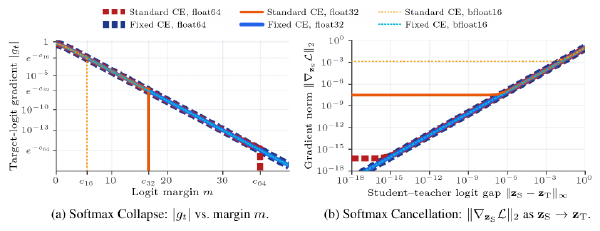
A Fix for Softmax and Cross-Entropy 24 October 2026·11 mins Machine Learning Paper Notes Machine-Learning Arxiv Numerics Optimization Adam Grokking Distillation Jax
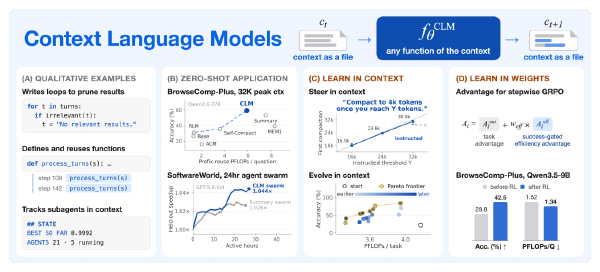
Context Language Models 3 October 2026·10 mins Machine Learning AI Engineering Paper Notes Nlp Arxiv Agents Context-Management Kv-Cache Reinforcement-Learning
Why Transformers Hit a Wall the Moment Physics Shows Up 29 August 2026·7 mins Machine Learning Talk Notes Ai-for-Science Neural-Operators Machine-Learning Weather-Modeling Scientific-Computing
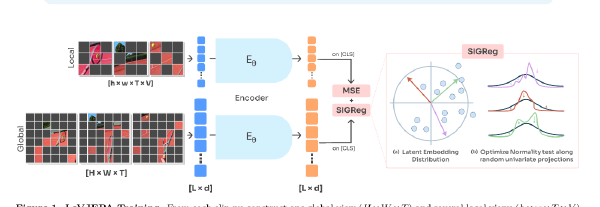
LeVJEPA: Efficient & Scalable Video Pretraining without the Heuristics 29 August 2026·12 mins Machine Learning Paper Notes Machine-Learning Arxiv Self-Supervised-Learning Video Representation-Learning Jepa
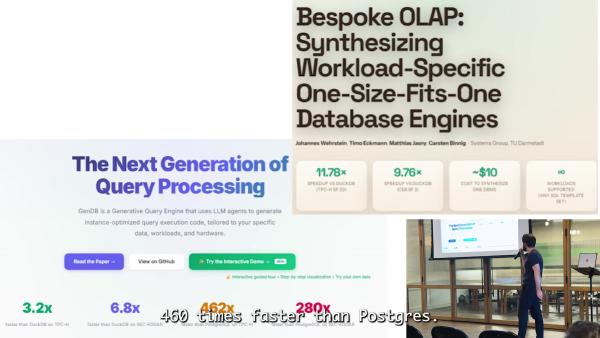
Can LLMs Build a 10x Faster Database? 29 August 2026·7 mins Databases Machine Learning Talk Notes Databases Llm Duckdb Query-Optimization Papers-We-Love
An Observation on Generalization 29 August 2026·8 mins Machine Learning Talk Notes Llm Machine-Learning Learning-Theory Compression Kolmogorov-Complexity
Let's Scale Step by Step: Compute-Efficient Hyperparameter Transfer for Large-Scale Mixture-of-Experts 22 August 2026·11 mins Machine Learning Paper Notes Machine-Learning Arxiv Mixture-of-Experts Scaling-Laws Pretraining
How Claude's Text Watermarking Works 22 August 2026·6 mins Machine Learning Talk Notes Llm Watermarking Sampling Ai-Safety From-Scratch
Who Gets to Be at the Frontier of Discovery 15 August 2026·6 mins Machine Learning Talk Notes Llm Ai-Research Continual-Learning Post-Training Open-Models
Synthetic Persona Pretraining: Alignment from Token Zero 15 August 2026·10 mins Machine Learning Paper Notes Machine-Learning Arxiv Alignment Pretraining Llm Safety
Lessons from Studying Every Memory System 15 August 2026·6 mins AI Engineering Machine Learning Talk Notes Ai-Engineering Memory Llm Context-Engineering Agents
Stanford CS329A: Self-Improving AI Agents — Course Overview 8 August 2026·7 mins AI Engineering Machine Learning Talk Notes Ai-Engineering Llm Agents Reinforcement-Learning Inference-Scaling Stanford
Scaling to Long Horizons: What Galactica Taught Us About RL 1 August 2026·7 mins AI Engineering Machine Learning Talk Notes Ai-Engineering Llm Reinforcement-Learning Post-Training Long-Horizon Evals
Windowed-MTP: Removing the Full-Context Draft-KV Tax at Million-Token Context 25 July 2026·3 mins Machine Learning AI Infrastructure Paper Notes Machine-Learning Arxiv Inference Speculative-Decoding Long-Context Llm-Systems